
Dream: ein KI-Bibliothekar für deine Notizen (Teil 1)
Je mehr ich täglich mit KI arbeite, desto unordentlicher werden meine eigenen Notizen. Dream ist ein kleiner nächtlicher Prozess, der meinen Wissensspeicher konsolidieren hilft, ohne ihn umzuschreiben. Teil 1: das Prinzip und der Bau. Teil 2 in zwei Wochen, mit den Daten.
19. Mai 20267 Min. LesezeitMichael Fellner
Je mehr ich täglich mit KI arbeite, desto seltsamer werden meine eigenen Notizen. Lektionen, die ich vor drei Monaten gelernt habe, tauchen in jeder neuen Sitzung als frische Erkenntnisse wieder auf. Alte Projektdateien widersprechen neueren, die Torpfosten verschieben sich, manchmal weil ich meine Meinung ändere, oder ein Kunde seine. Manchmal schlicht, weil nach ein paar Wochen Pause bessere Konzepte entstehen. Ich sitze auf einem Ordner voller Entscheidungen vom Januar und entdecke im März dieselbe Schlussfolgerung noch einmal, weil nichts die beiden verbunden hat. Mensch zu sein bringt Grenzen mit sich. Bei mir ist eine davon, dass es mitunter herausfordernd ist, mich an den Wochentag zu erinnern. Die KI wird immer besser darin, mir zu helfen. Mein Wissensspeicher wird immer schlechter darin, die aktuelle Realität abzubilden.
Diesen Monat habe ich etwas gebaut, um einen anderen Ansatz zu testen. Ich habe es Dream genannt. Die Idee ist nicht originell. Anthropic hat seine Version, ebenfalls Dreaming genannt, zwei Wochen bevor ich mit meiner anfing, angekündigt. Was mir schreibenswert erscheint, ist nicht der Bau selbst, sondern eine neue Deutung dessen, wozu der Mechanismus da ist. Das hier ist Teil 1: das Prinzip und die Architektur. Teil 2 wird in zwei Wochen zeigen, was tatsächlich passiert ist: habe ich Zeit und Energie verschwendet, oder hat dieser Ansatz einen Wert.
Fakten ändern sich, die KI merkt es nicht
Drei Arten, wie es schiefgehen kann, alle vertraut für jeden, der neben dem täglichen KI-Einsatz einen eigenen Wissensspeicher führt.
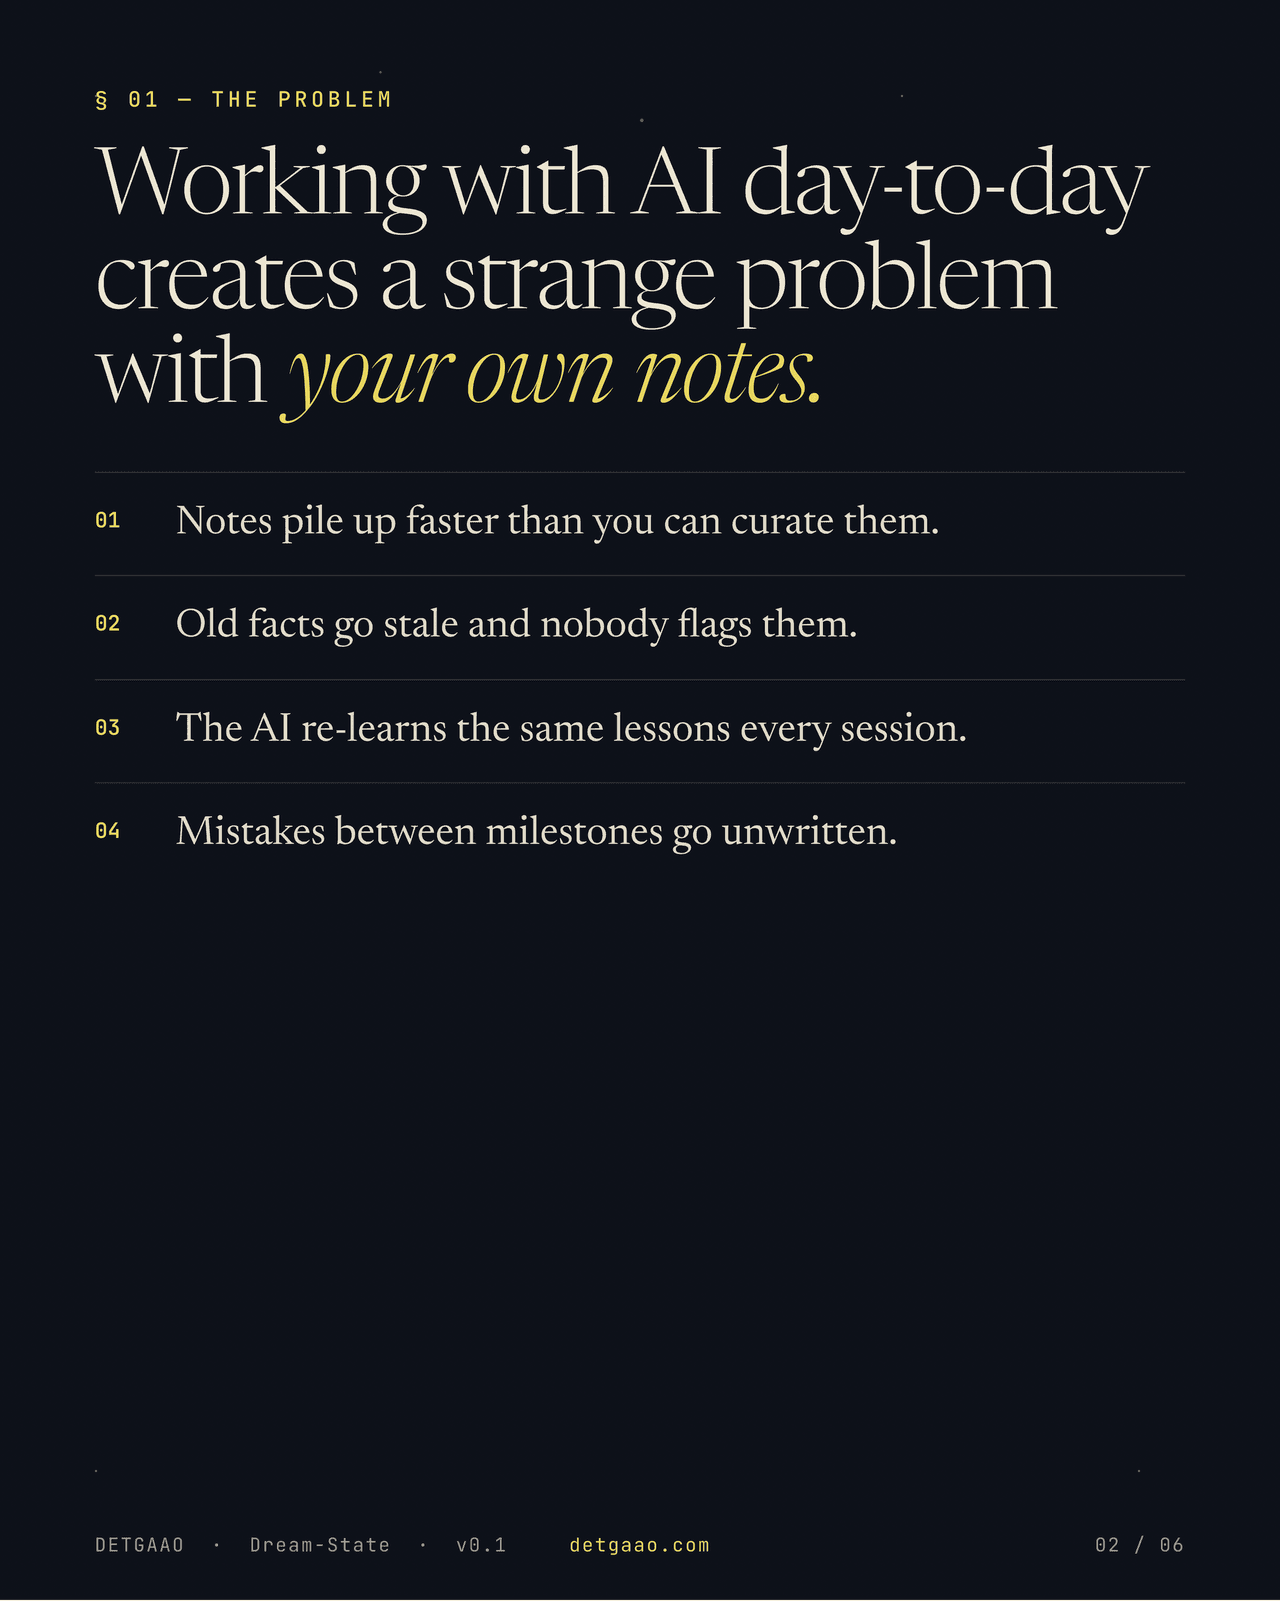
Die erste ist die Menge. Notizen stapeln sich schneller, als ich sie durchsehen kann. Jede Sitzung produziert Ideen, Entscheidungen, Fragmente. Das meiste wird gespeichert. Weniges wird je wieder gelesen. Was eigentlich ziemlich genau dasselbe ist, was mit meinen handschriftlichen Notizen, Notizbüchern und Post-its passiert ...
Die zweite ist das Veralten. Eine Entscheidung, die ich im Januar zur Positionierung von DETGAAO getroffen habe, liegt im Mai noch in meinen Dateien, obwohl ich im März eine schärfere Fassung derselben Entscheidung getroffen habe. Beide Dateien existieren. Keine weiss von der anderen.
Die dritte ist die Wiederholung. Lektionen, für die ich Wochen gebraucht habe, verschwinden zwischen den Sitzungen. Das nächste Mal, wenn ich ein frisches Projekt öffne, erarbeite ich sie mir erneut. Die KI macht ihre Sache gut. Kaputt ist die Eingabe, nicht das Modell. Aber die Eingabe ist meine, und ich pflege sie nicht aktiv genug.
Also habe ich einen Ordner mit "Entscheidungen", der langsam zu einem Ordner mit "Entscheidungen, die vielleicht noch stimmen und vielleicht auch nicht" wird. Niemand prüft das. Niemand liest die älteren Dateien neben den neueren. Der Schritt der Konsolidierung existiert nicht. Wieder ähnlich wie bei handschriftlichen Notizen, wo man eine Konsolidierung versuchen kann und dann ewig damit verbringt, Notizbücher und lose Blätter zu durchforsten, um herauszufinden, warum und wann man etwas aufgeschrieben hat.
Anthropics Dreaming: Agenten hören auf zu vergessen
Am 6. Mai hat Anthropic an der Code with Claude in San Francisco eine Funktion namens Dreaming angekündigt. Mahesh Murag, Produktmanager im Plattformteam, ist das Design durchgegangen. Der Mechanismus ist unkompliziert. Ein geplanter Hintergrundlauf liest die vergangenen Sitzungen eines Agenten und dessen bestehenden Gedächtnisspeicher. Er sucht nach Mustern, wiederkehrenden Fehlern und nützlichen Arbeitsabläufen. Er schreibt einen neuen, neu geordneten Gedächtnisspeicher: Duplikate zusammengeführt, Widersprüche aufgelöst, neue Erkenntnisse sichtbar gemacht. Maheshs Präsentation hat mich inspiriert.
Die zentrale Sicherheitsregel, in Anthropics eigener Formulierung: Der Eingabespeicher wird nie verändert. Das Ergebnis ist überprüfbar. Du kannst es wegwerfen, wenn dir nicht gefällt, was dabei herauskommt.
Erste Zahlen von Beta-Kunden waren beachtlich. Harvey, das Legal-KI-Startup, sah bei einer Klasse von juristischen Entwurfsaufgaben ungefähr die sechsfache Abschlussquote, sobald Dreaming eingeschaltet war. Rakuten meldete bei der verwandten Memory-Funktion 97% weniger Fehler im ersten Durchgang. Das sind herstellereigene Ergebnisse und sollten als Richtungsangabe gelesen werden, nicht als Evangelium. Ich bin grundsätzlich ein Skeptiker. Trotzdem sind sie substanziell genug, um sie ernst zu nehmen, sogar von mir.
Das Problem, das Anthropic löst, ist real: KI-Agenten vergessen über Sitzungen hinweg, was funktioniert hat, und so scheitern dieselben Aufgaben jedes Mal auf dieselbe Weise. Dreaming ist dazu gedacht, das zu beheben.
Derselbe Mechanismus, ein anderes Ziel
Beim Zuschauen hat mich vor allem gepackt, dass derselbe Mechanismus, auf ein anderes Problem gerichtet, für mich persönlich nützlich sein könnte. Was ich konsolidiert haben will, ist nicht das Gedächtnis eines KI-Agenten. Es ist mein eigener Wissensspeicher. Das Dev-Brain, die Projektnotizen, die Übergaben, das Entscheidungsprotokoll. Die Orte, an die ich zum Denken gehe.
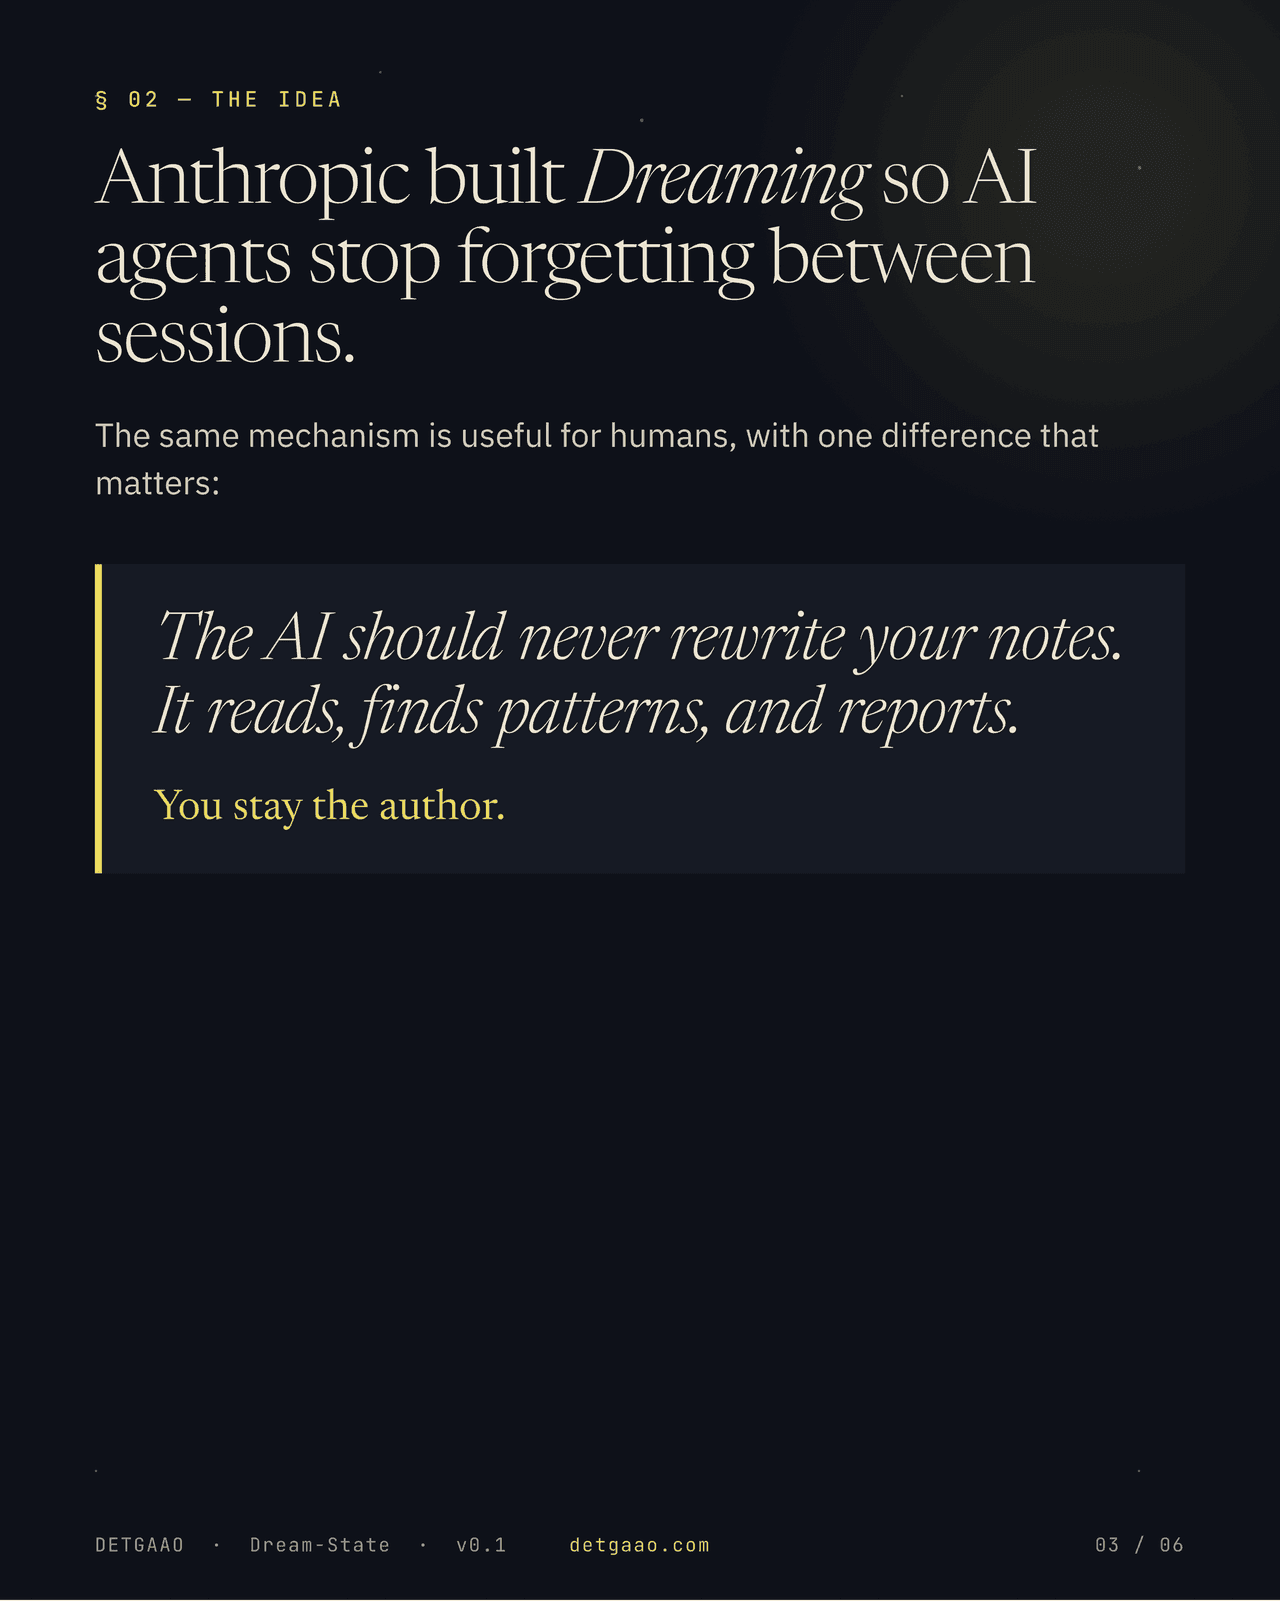
Die Regeländerung ist klein, aber sie zählt. Anthropics Dreaming schreibt den Gedächtnisspeicher des Agenten um, und der Agent benutzt beim nächsten Mal die neue Fassung. Für einen menschlichen Wissensspeicher ist das die falsche Form. Wenn du eine KI deine Notizen umschreiben lässt, verlierst du die Autorschaft an deinem eigenen Denken. Selbst wenn die KI richtig liegt, ist die Datei jetzt in einer Stimme geschrieben, die nicht deine ist. Selbst wenn sie falsch liegt, ist die falsche Fassung jetzt die Quelle der Wahrheit.
Das Prinzip, von dem ich also ausgegangen bin: KI soll Bibliothekar sein, nicht Koautor.
Ein Bibliothekar ordnet, erschliesst, markiert Duplikate und weist darauf hin, wo etwas besser hinpassen würde. Ein Koautor schreibt Dinge in seiner eigenen Stimme um. Der Bibliothekar lässt die Bücher in Ruhe. Der Koautor schlägt sie auf und ändert die Wörter.
Für meinen eigenen Wissensspeicher will ich den Bibliothekar.
Was ich gebaut habe (drei Schichten und eine Freigabe)
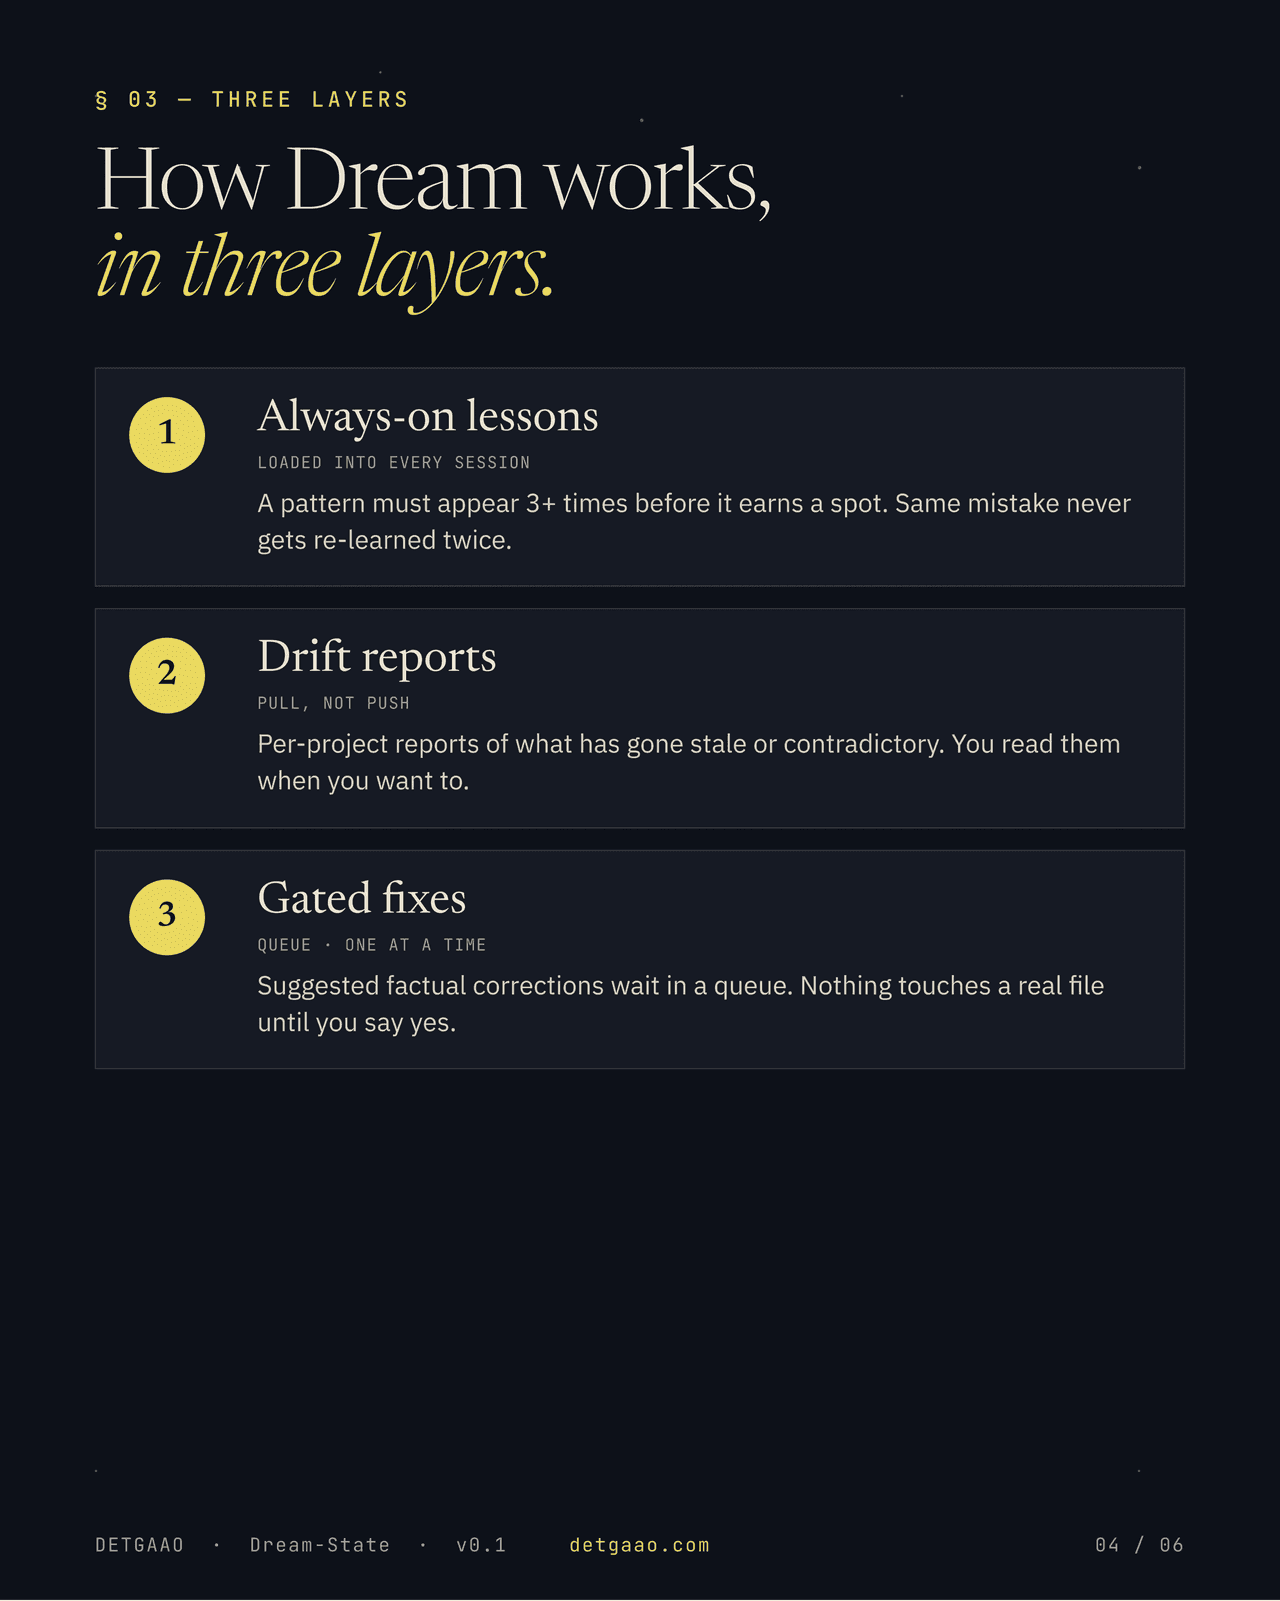
Dream ist die praktische Fassung dieses Prinzips. Es läuft als ein einziger geplanter Skill, mit drei Ergebnissen und einer strikten Nur-Lese-Regel für meine tatsächlichen Dateien.
Dauerhaft geladene Lektionen. Eine kleine gemeinsame Datei mit wiederkehrenden Lektionen. Ein Muster muss an mindestens drei verschiedenen Stellen auftauchen, bevor es sich seinen Platz verdient. Drei ist eine Annahme, die ich treffen musste. Reicht das? Zu streng? Zu locker? Die Datei wird in jede künftige Agentensitzung geladen, damit dieselbe Lektion nicht neu gelernt werden muss. Sie ist bewusst winzig. Sie ist nicht Teil meiner Notizen. Sie ist ein separater Notizblock.
Drift-Berichte. Projektbezogene Berichte darüber, was veraltet ist, was wem widerspricht, was nicht mehr stimmt. Sie liegen in einem Ordner. Ich lese sie, wenn ich will. Nichts lädt sich von selbst in mein Arbeitsgedächtnis.
Freigabepflichtige Korrekturen. Vorgeschlagene sachliche Korrekturen warten in einer Warteschlange. Keine echte Datei wird angerührt, bevor ich jede einzelne freigegeben habe. Die Warteschlange ist kurz und konkret: hier ist die Datei, hier ist die Zeile, hier ist, was Dream ändern würde, hier ist warum. Ich gebe frei, bearbeite oder lehne ab.
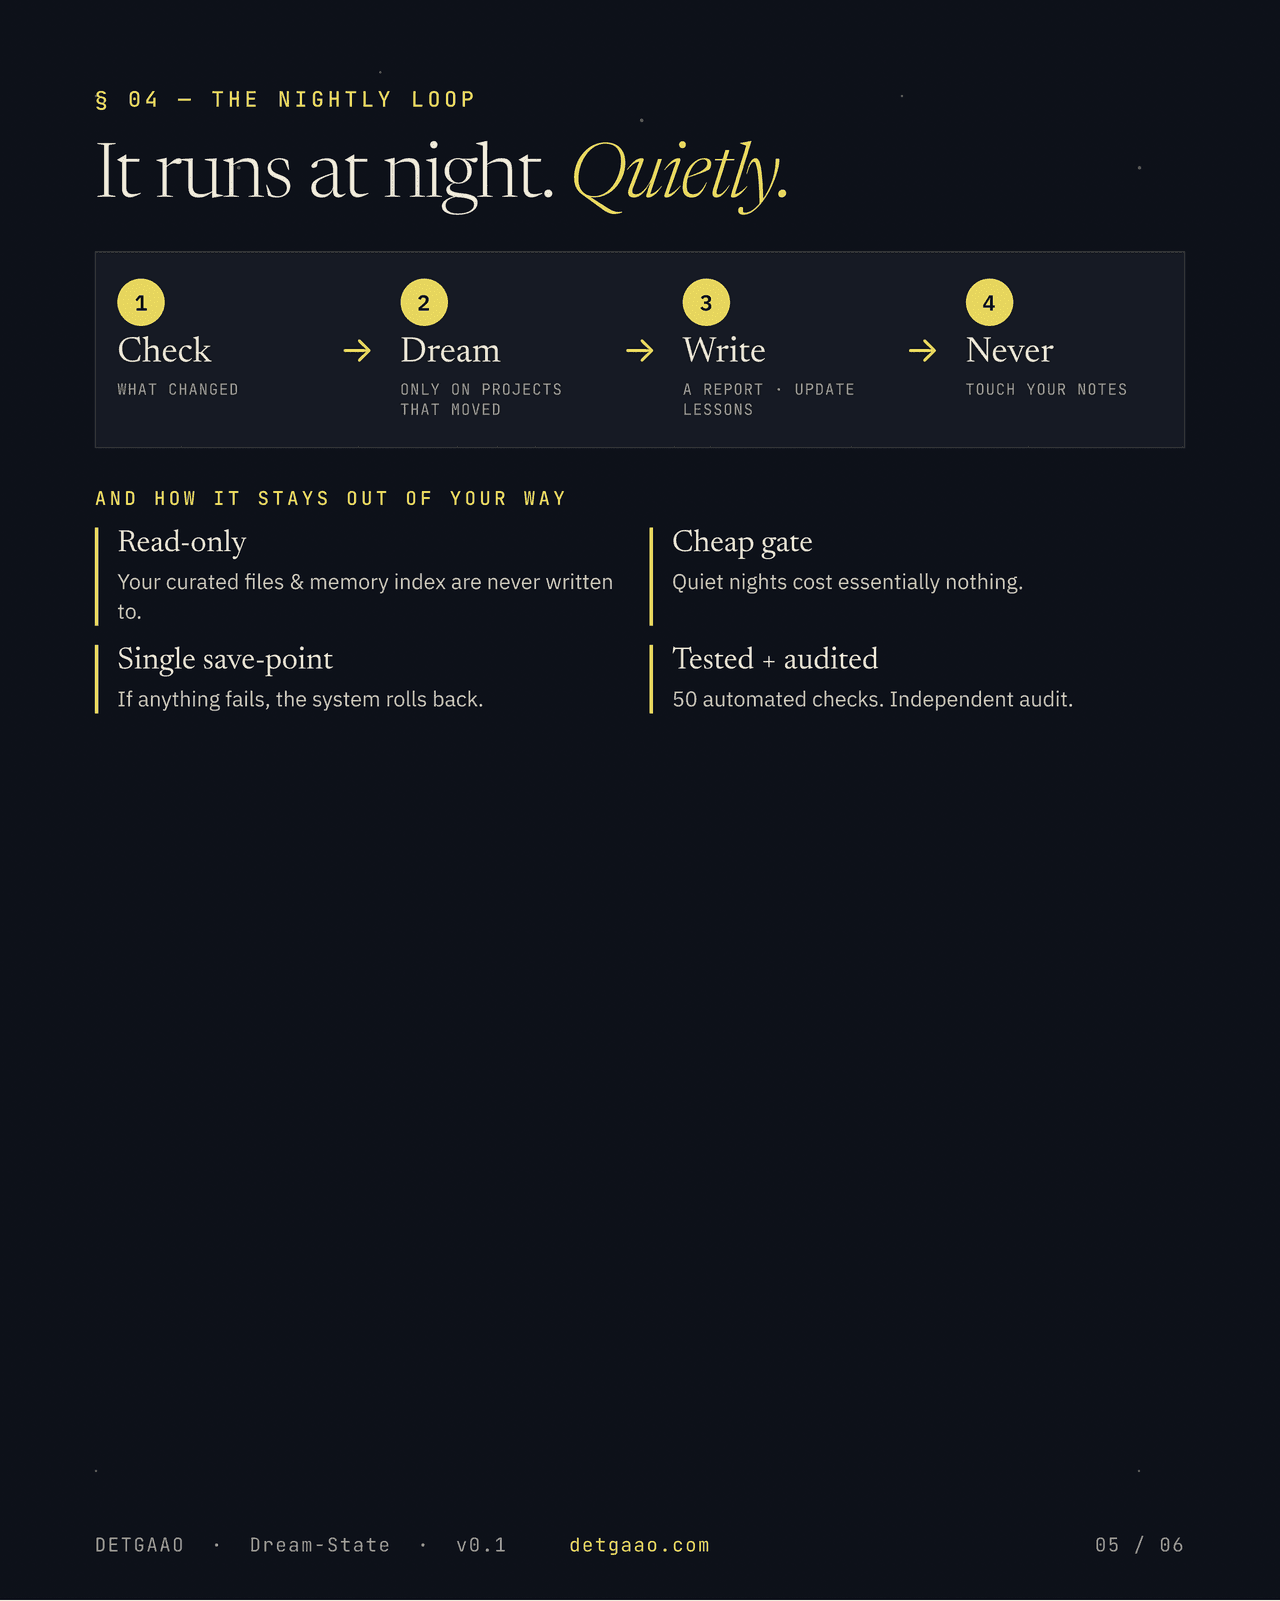
Die Freigaben, der Teil, der die meiste Sorgfalt gekostet hat:
- Nur Lesezugriff auf meine Notizen. In meine Dateien und den Gedächtnisindex schreibt Dream nie. Zwei unabhängige Code-Reviews und ein Audit haben das bestätigt.
- Ein billiger Rechner entscheidet, ob sich der Durchlauf heute Nacht lohnt, nicht die KI. Ruhige Nächte kosten praktisch nichts. Keinen Prozess zu schaffen, der mein Nutzungs- und Token-Budget zerlegt, war eine zentrale Überlegung bei der Konzeption dieses 'Werkzeugs'.
- Ein einziger Speicherpunkt. Fällt mitten im Durchlauf etwas aus, rollt das System zurück. Als hätte es nie gelaufen.
- 50 automatisierte Kontrollen. Unabhängiges Audit. Keine Sicherheitsprobleme gefunden.
Der nächtliche Durchlauf ist klein: prüfen, was sich über die Projekte hinweg geändert hat, nur über die träumen, die sich bewegt haben, einen Bericht schreiben und die Lektionsdatei aktualisieren, die Notizen nie anrühren. Das ist alles.
Es läuft derzeit im beaufsichtigten Testbetrieb. Ich lese jedes Ergebnis. Irgendwann will ich es portierbar haben, damit es auf jedem beliebigen Wissenssystem aufsetzen kann (Obsidian, Notion, blosse Markdown-Ordner). Vorerst läuft es auf meinem.
Was Teil 2 beantworten wird
Dieser Beitrag ist das Prinzip und die Architektur. Der empirische Beitrag kommt in zwei Wochen, um den Anfang Juni herum, dann wissen wir, ob ich den Verstand verloren habe und an KI-Psychose leide, oder ob ich einen tauglichen Weg gefunden habe, den Projekt- und Entwicklungsprozess zu verbessern. Wetten nehme ich die nächsten paar Tage entgegen.
Ein paar Fragen, die ich zu beantworten versuchen werde:
- Annahmequote bei den freigabepflichtigen Korrekturen. Wie oft hat Dream eine sachliche Korrektur richtig getroffen? Wie oft habe ich sie überstimmt? Das Verhältnis ist das Vertrauenssignal.
- Überraschende Funde. Alles, was Dream markiert hat und ich selbst nicht gefunden hätte. (Was nicht allzu schwierig sein dürfte)
- Fehlalarme. Wo Dream selbstbewusst Dinge vorgeschlagen hat, die falsch waren. Damit rechne ich fest. Mich interessiert, ob manche auf lehrreiche Weise falsch sein werden.
- Wo das Design gehalten hat. Wo es gebrochen ist.
Ich werde ehrlich darüber berichten. Wenn die Antwort lautet "das ist mehr Aufwand, als es wert ist, und ich schalte es ab", sehe ich das als genauso nützliche Erkenntnis wie das Gegenteil. Wenn die Antwort lautet "das verändert tatsächlich, wie ich arbeite", ist das offensichtlich der Beitrag, den ich lieber schreiben würde. Beides sind echte Ergebnisse. Das Stück in zwei Wochen schreibt sich so oder so von selbst.
Wenn du über etwas Ähnliches für dein eigenes Setup nachdenkst, wäre mir lieber, du wartest mit der Entscheidung bis Teil 2. Im Moment ist die Idee, das Prinzip, interessanter als der Bau. Die Daten werden uns sagen, ob es sich lohnt, dem Prinzip zu folgen.
Häufig gestellte Fragen
- Was ist Dream?
- Dream ist ein geplanter nächtlicher Prozess, der einen menschlichen Wissensspeicher liest und darüber berichtet, ohne ihn umzuschreiben. Es entstehen drei Dinge: eine kleine gemeinsame Datei mit wiederkehrenden Lektionen, die in jede Sitzung geladen wird, projektbezogene Drift-Berichte, die in einem Ordner liegen, bis du sie liest, und eine Warteschlange mit vorgeschlagenen sachlichen Korrekturen. Keine echte Datei wird angerührt, bevor jede Korrektur einzeln freigegeben ist. Die Notizen selbst bleiben nur lesbar.
- Was ist Anthropics Funktion Dreaming?
- Anthropic hat Dreaming am 6. Mai 2026 an der Code with Claude in San Francisco angekündigt. Ein geplanter Hintergrundlauf liest die vergangenen Sitzungen eines Agenten und dessen bestehenden Gedächtnisspeicher, sucht nach Mustern, wiederkehrenden Fehlern und nützlichen Arbeitsabläufen und schreibt dann einen neuen, neu geordneten Speicher, in dem Duplikate zusammengeführt und Widersprüche aufgelöst sind. Der Eingabespeicher wird nie verändert, und das Ergebnis ist überprüfbar, du kannst es also wegwerfen. Harvey meldete bei juristischen Entwurfsaufgaben ungefähr die sechsfache Abschlussquote.
- Warum sollte eine KI die eigenen Notizen nicht umschreiben?
- Weil du damit die Autorschaft an deinem eigenen Denken verlierst. Liegt die KI richtig, ist die Datei jetzt in einer Stimme geschrieben, die nicht deine ist. Liegt sie falsch, ist die falsche Fassung zur Quelle der Wahrheit geworden. Das brauchbare Bild ist der Bibliothekar statt des Koautors: Ein Bibliothekar ordnet, erschliesst, markiert Duplikate und weist darauf hin, wo etwas besser hinpassen würde, und lässt die Bücher dabei in Ruhe.
- Wie verhindert Dream, dass es die gelesenen Dateien verändert?
- Über vier Sicherungen. Dream schreibt nie in die Notizen oder den Gedächtnisindex, was zwei unabhängige Code-Reviews und ein Audit bestätigt haben. Ein billiger Rechner entscheidet, nicht die KI, ob sich ein Durchlauf in dieser Nacht lohnt, ruhige Nächte kosten deshalb praktisch nichts. Ein einziger Speicherpunkt rollt den gesamten Lauf zurück, falls mittendrin etwas ausfällt. 50 automatisierte Kontrollen und ein unabhängiges Audit fanden keine Sicherheitsprobleme. Vorgeschlagene Korrekturen warten weiterhin auf die einzelne Freigabe.
Weiterlesen
Wo das in der Arbeit vorkommt
Signal per E-Mail
Eine E-Mail, wenn es einen neuen Beitrag gibt. Keine Serie, kein Digest, keine Automatikstrecke.
Lieber im Reader? Signal gibt es auch als RSS-Feed
Google lässt dich festlegen, welche Quellen dir häufiger angezeigt werden. Markier DETGAAO als bevorzugte Quelle, und Signal rückt in deinen Suchergebnissen nach oben – in deinen, nicht in allen.
Als bevorzugte Quelle hinzufügenEin Klick, jederzeit in deinen Google-Einstellungen widerrufbar.
Möchtest du besprechen, was sich dadurch für deine Marketing-Operations ändert?
Neugierig?